

Python自动化测试:XPath定位元素的核心技巧与实战

本文深入解析Python自动化测试中XPath定位元素的多种高级用法。涵盖通过基本属性、其他属性及标签名进行精准定位,详解相对路径与绝对路径的层级遍历逻辑,讲解利用索引处理兄弟元素的技巧,以及结合逻辑运算(and/or/not)和模糊匹配(contains/text())解决复杂DOM结构的实战方案。
一、XPath:基本属性定位
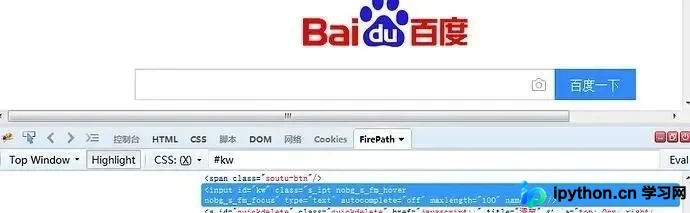
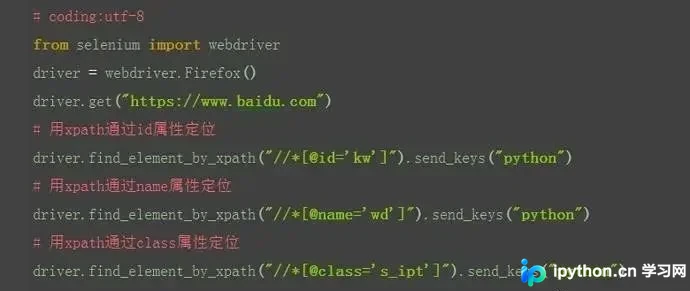
在前文介绍中,我们学习了如何通过元素的id、name或class等标准属性来定位目标元素。实际上,利用XPath方法并结合这些元素属性,同样能够实现高精度的元素定位,具体效果可参考下图展示。
基于上述原理,我们可以采用以下XPath语法来实现定位操作。
二、XPath:其他属性定位
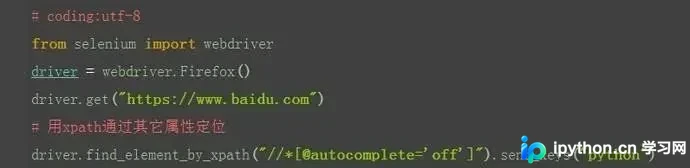
在实际开发场景中,经常遇到某些HTML元素缺乏id、name或class等常见属性。此时,我们可以转而利用元素的任意其他属性(如data-*、href、value等)来准确定位目标元素。
三、XPath:标签定位
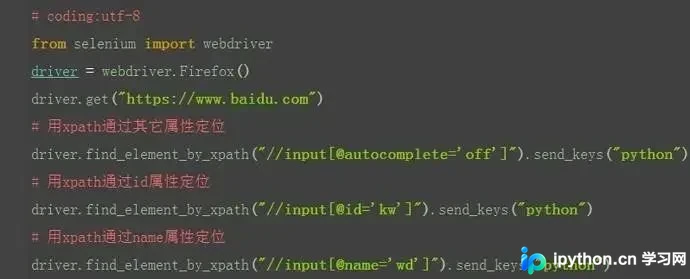
在实际工作中,常会遇到多个元素拥有相同属性值的情况,导致定位不唯一。此时,通过指定具体的HTML标签名称进行筛选,可以显著提高定位的准确性。
若无需指定特定标签名称,可以使用通配符*来匹配任意类型的HTML标签。
若需指定具体的HTML标签(如div、input等),则直接在XPath表达式中书写该标签名称即可。
四、XPath:相对路径与绝对路径定位
当目标元素的属性特征不明显,难以直接定位时,我们可以采用层级遍历策略:首先定位其父元素。
在成功定位父元素后,再通过子节点关系向下查找,即可定位到目标元素。
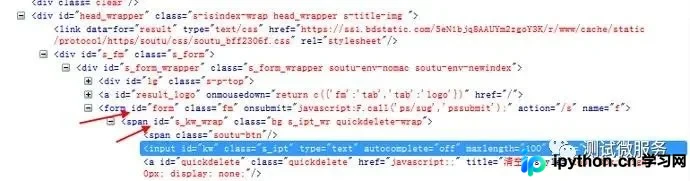
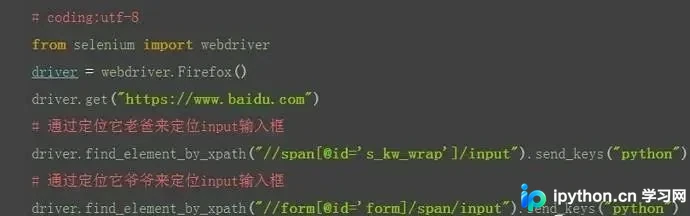
如上图所示,若需定位input标签,可先定位其父元素(文中称为“老爸”),该父元素的id属性值为s_kw_wrap。
若父元素的属性同样不明显,可继续向上追溯至祖父元素,例如id为form的元素。
通过构建完整的层级路径关系,即可准确定位到目标元素。
五、XPath:索引定位
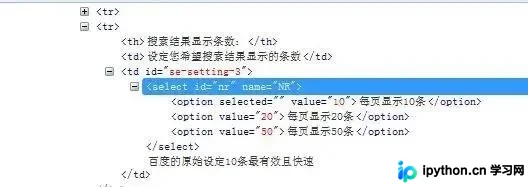
当目标元素存在多个兄弟元素且标签名相同时,仅靠层级关系无法唯一确定目标(如同“多胞胎兄弟”)。
尽管这些兄弟元素外观相似,但它们在DOM树中的出现顺序是固定的。因此,可以通过指定元素在父节点下的索引位置(即“排行”)来进行定位。
如下图所示,假设存在三个结构相同的兄弟元素。
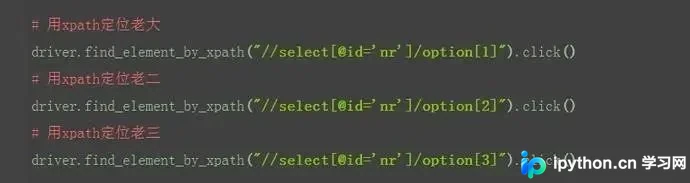
利用XPath索引可以分别定位第一个、第二个和第三个元素。需要注意的是,XPath的索引是从1开始计数的,这与Python列表从0开始的索引规则不同。
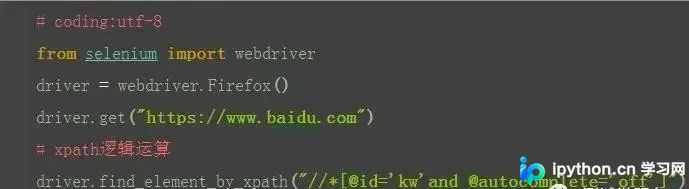
六、XPath:逻辑运算
XPath支持强大的逻辑运算功能,允许组合多个属性条件,支持与(and)、或(or)以及非(not)逻辑操作。
在实际应用中,最常用的是and运算,即要求元素同时满足多个属性条件。
七、XPath:模糊匹配
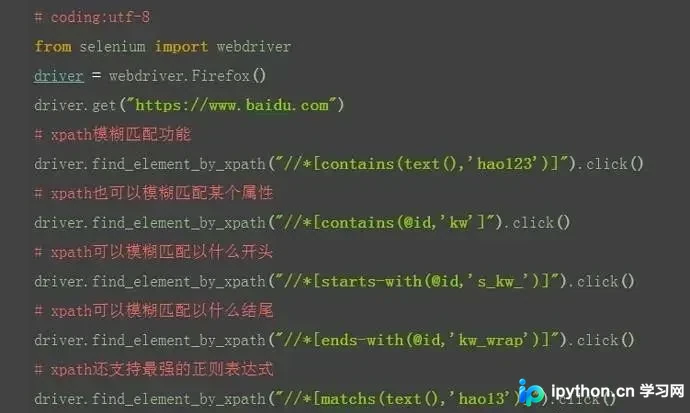
XPath还具备强大的模糊匹配能力,这是其区别于其他定位方式的重要优势。
掌握模糊匹配技巧后,绝大多数DOM元素的定位问题均可迎刃而解。
例如,在百度页面定位“hao123”超链接时,除了使用by_link或by_partial_link方法外,XPath同样支持模糊匹配,且功能更为灵活强大。
可以说,XPath是元素定位领域中的“屠龙刀”,功能强大且覆盖面广。
至此,关于Python自动化测试中XPath定位方法的详细介绍已完毕。如需了解更多Python相关XPath内容,建议查阅本站往期文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









