

Python3使用xlrd、xlwt处理Excel方法数据

本文介绍如何在Python3环境中使用xlrd和xlwt库处理Excel文件。通过实例演示如何安装库、读取Sheet信息、获取行列数据、处理日期格式及识别合并单元格,帮助开发者高效进行Excel数据的二次处理与预测分析。
前言
前言
近期在进行毕业设计,课题为道路拥堵预测系统。根据建议,拟采用SVM算法进行预测,但在此之前需对Excel原始数据进行二次处理,因为原始数据格式并不直接满足分析需求。面对高达346469条的数据量,逐一进行运算及归一化处理显然不可行。
作为Java开发者,此前未曾接触过Python,选择此课题颇具挑战。经查阅资料发现,xlrd库可通过Python代码读取Excel文件,其名称意为xls文件的read(只读);而xlwt则是其对应写入操作的库,用于执行写入功能。接下来将展开具体操作。
作为初学者,恳请Python资深专家勿喷,我们怀着学习的心态共同探讨这两个库的具体使用方法。
xlrd库的使用
一、xlrd的使用
篇幅较长,本文仅介绍xlrd的使用,xlwt将在下篇继续。
使用前需先安装,若在Windows系统下已安装Python环境,可直接打开cmd输入:$ pip install xlrd。xlwt的安装方式相同,不得不说Python的类库确实便捷(此处略过题外话)。
假设我们需要修改以下Excel中的数据:
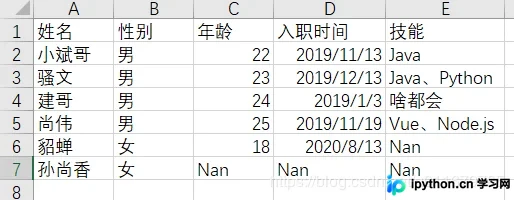
该表格结构包含两层:
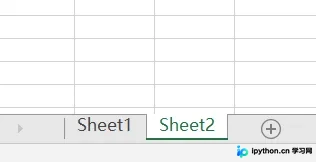
首先导入xlrd库。
import xlrd接着读取数据文件。
workbook = xlrd.open_workbook(r'E:\test.xlsx')然后打印Sheet相关信息。
print(workbook.sheet_names())打印结果如下:
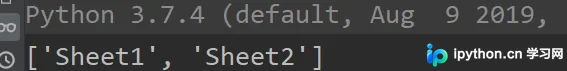
通过下标获取表单。
print(workbook.sheet_names()[1])在方法后添加中括号,内部指定表单位置。例如输入1表示第二页,打印结果如下:
根据索引或名称获取数据的名称、行或列信息。
index = workbook.sheet_by_index(0)# 根据索引或者行数列数和名称
print('索引名称:'+str(index.name)+' 索引的行数'+
   str(index.nrows)+' 索引的列数'+str(index.ncols))
输出结果如下:
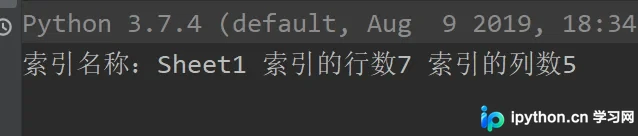
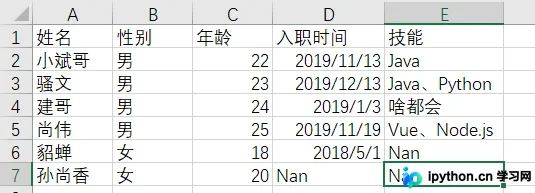
结果显示为七行五列,无误。
同样,通过表单名称也能获取Sheet对象。
index2 = workbook.sheet_by_name('Sheet1')
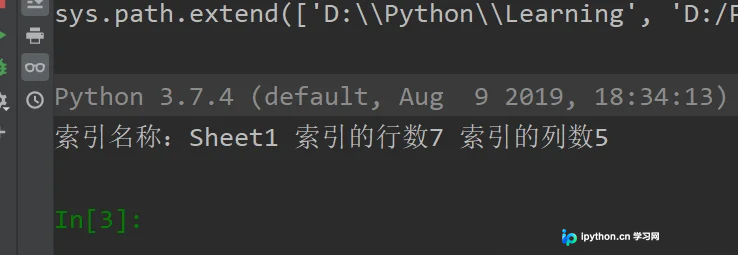
print('索引名称:'+str(index2.name)+' 索引的行数'+
   str(index2.nrows)+' 索引的列数'+str(index2.ncols))
输出结果如下:
获取整行或整列的内容。
重点来了,如何获取一整行或一整列的内容? 首先需要获取表单对象,通过上述两种方法之一: 我习惯使用名称获取:
sheet1= workbook.sheet_by_name('Sheet1')获取对象后:
row_values = sheet1.row_values(2)
print('第三行的内容:'+str(row_values))
col_values = sheet1.col_values(2)
print('第三列的内容'+str(col_values))
查看输出结果:
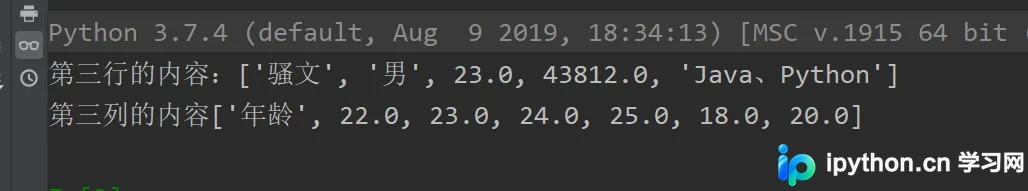
至于时间显示为43812.0,这代表天数,可转换为日期格式,后续将详细介绍用法。
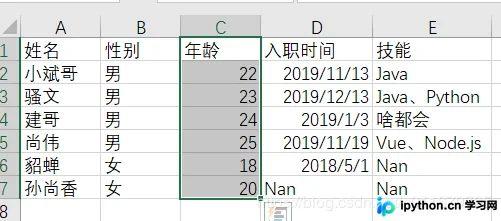
结果完全正确。
获取具体行列数据
获取具体某行某列的内容。
此方法有多种,可按个人习惯选择,这里列举六种:
print(sheet1.cell_value(1, 1))
print(sheet1.cell(1, 1))
print(sheet1.row(1)[1])
print(sheet1.col(1)[1])
print(sheet1.row_values(1)[1])
print(sheet1.col_values(1)[1])
若想知道某行某列的数据类型,该如何操作?
print(sheet1.cell(1, 0).ctype)
print(sheet1.cell(1, 2).ctype)
print(sheet1.cell(1, 3).ctype)
输出结果为:
1 2 3
ctype分别代表:0空值,1字符串,2数字,3日期,4布尔值,5错误。
提示:打印时需注意类型问题。
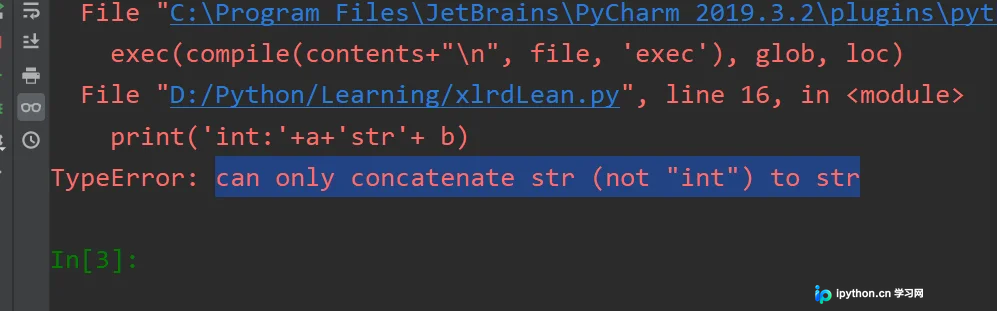
Python与Java在类型转换上存在较大差异,这一点我更倾向于Java的处理方式(打印时统一转换为String类型)。例如,若想打印多种类型的属性,同时打印没问题,但Python必须限定类型为str,否则报错。
public class test {
  public static void main(String[] args) {
    int num = 1;
    String ss = "sss";
    System.out.println("Integer"+num+"String"+ss);
  }
}
Java完全可以正常运行: Python:
a = 1
b = 'ss'
print('int:'+a+'str'+ b)
拼接字符串时必须限定a和b为str类型,否则报错。 报错内容如下:
日期格式处理
如何将date类型转换为float类型的数字。
若要修改时间格式的属性:
as_tuple = xlrd.xldate_as_tuple(sheet1.cell_value(1, 3), workbook.datemode)cell_value(1,3) 表示获取 2019/11/13 这一单元格的数据。
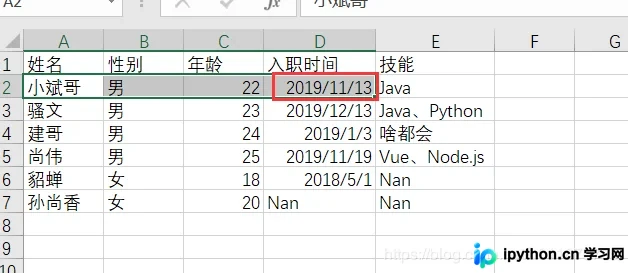
第二个参数datemode无需多解释,需修改哪个文件,就调用该文件对象的datemode属性。 我们输出一下as_tuple这个对象:
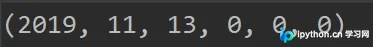
从该元组数据可以看出,前三个元素分别对应年月日,因此我们需要提取这三个数字:
d = date(*as_tuple[:3])date()方法需要三个参数,分别为年月日,因此提取元组的前三个数字正好适用: 我们打印一下:
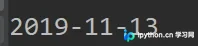
这正是我们需要的格式。 等等,我是用斜杠“/”分隔的,这里却是“-”,我们需要调整格式,通过strftime(string formate time)方法:
代码如下:
strftime = d.strftime('%Y/%m/%d')打印一下:
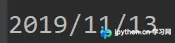
这样便完美解决了。
合并单元格处理
如何获取合并单元格。
我们切换到sheet2。
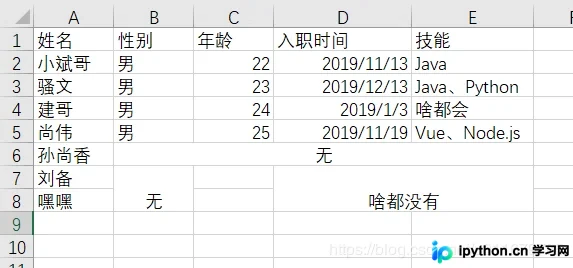
可以看到第六行的第2-5列均为合并单元格,内容为空;第七行和第八行的第二列为合并单元格,内容为空;第七行和第八行的第四和第五列为合并单元格,内容同样为空。
我们需要使用merged_cells方法。
sheet2 = workbook.sheet_by_name('Sheet2')
print(sheet2.merged_cells)
输出结果如下:
[(5, 6, 1, 5), (6, 8, 1, 2), (6, 8, 3, 5)]
这串数字如5615、6812、6835是什么意思? 四个参数分别代表:起始行、结束行(不含最大行)、起始列、结束列(不含最大列)。 以5615为例,第五行到第六行的左闭右开区间[5,6),即第五行;[1,5)表示第一列到第四列,我们查看:
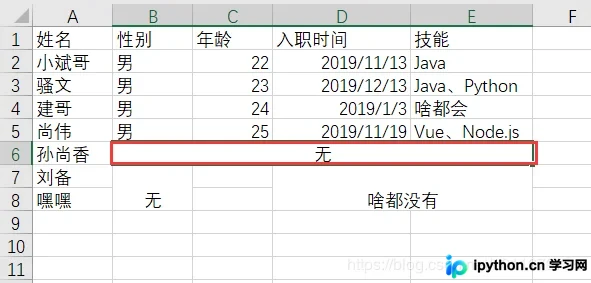
由于Python从零开始计数,Python中的第五行实际上对应Excel的第六行,第1-4列即对应Excel的第2-5列,这正是“无”所在的位置。这仅告知哪些是合并单元格,若想打印内容怎么办?
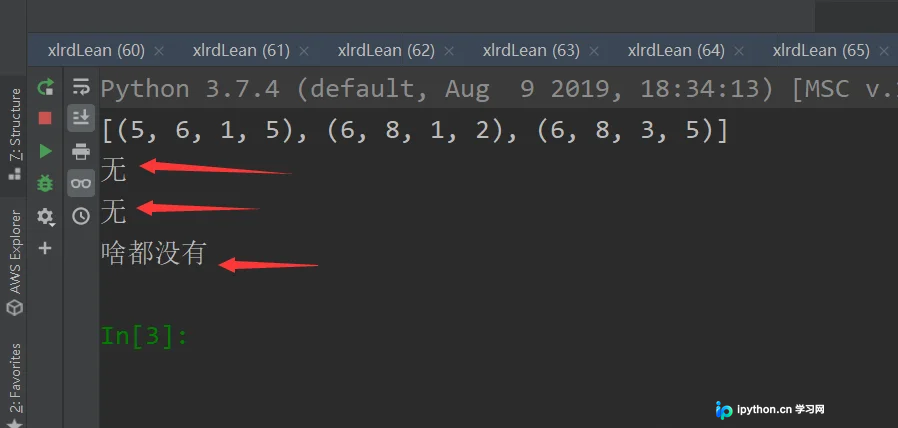
print(sheet2.cell_value(5, 1))
print(sheet2.cell_value(6, 1))
print(sheet2.cell_value(6, 3))
只需提取第一个和第三个参数即可打印出来。
看到此处说明你非常努力,看懂为主。感谢点赞,如有错误请指正,有问题欢迎留言。再见。
到此关于Python3使用xlrd、xlwt处理Excel方法数据的文章介绍完毕,更多相关内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









