

Kubernetes日志:kubectl logs与stern实时流

认识Kubernetes容器日志与kubectl logs
Kubernetes默认通过容器运行时(如containerd或CRI-O)捕获容器标准输出(stdout)与标准错误(stderr),并将其以文件形式持久化在节点/var/log/containers/目录下。kubectl logs命令正是通过调用Kubelet API读取这些日志文件。基础用法为kubectl logs <pod-name>,若Pod包含多个容器,需使用-c参数明确指定目标容器。例如执行kubectl logs my-app-7d9f8b6c-x2k4p -c worker即可精准拉取worker容器的运行记录。该命令默认返回最新日志片段,适用于快速验证应用启动状态或检查基础报错。理解这一底层机制有助于排查日志缺失问题,例如当容器未将日志输出至stdout而是写入本地文件时,kubectl logs将无法捕获内容,此时需调整应用日志配置或引入Sidecar日志采集器。
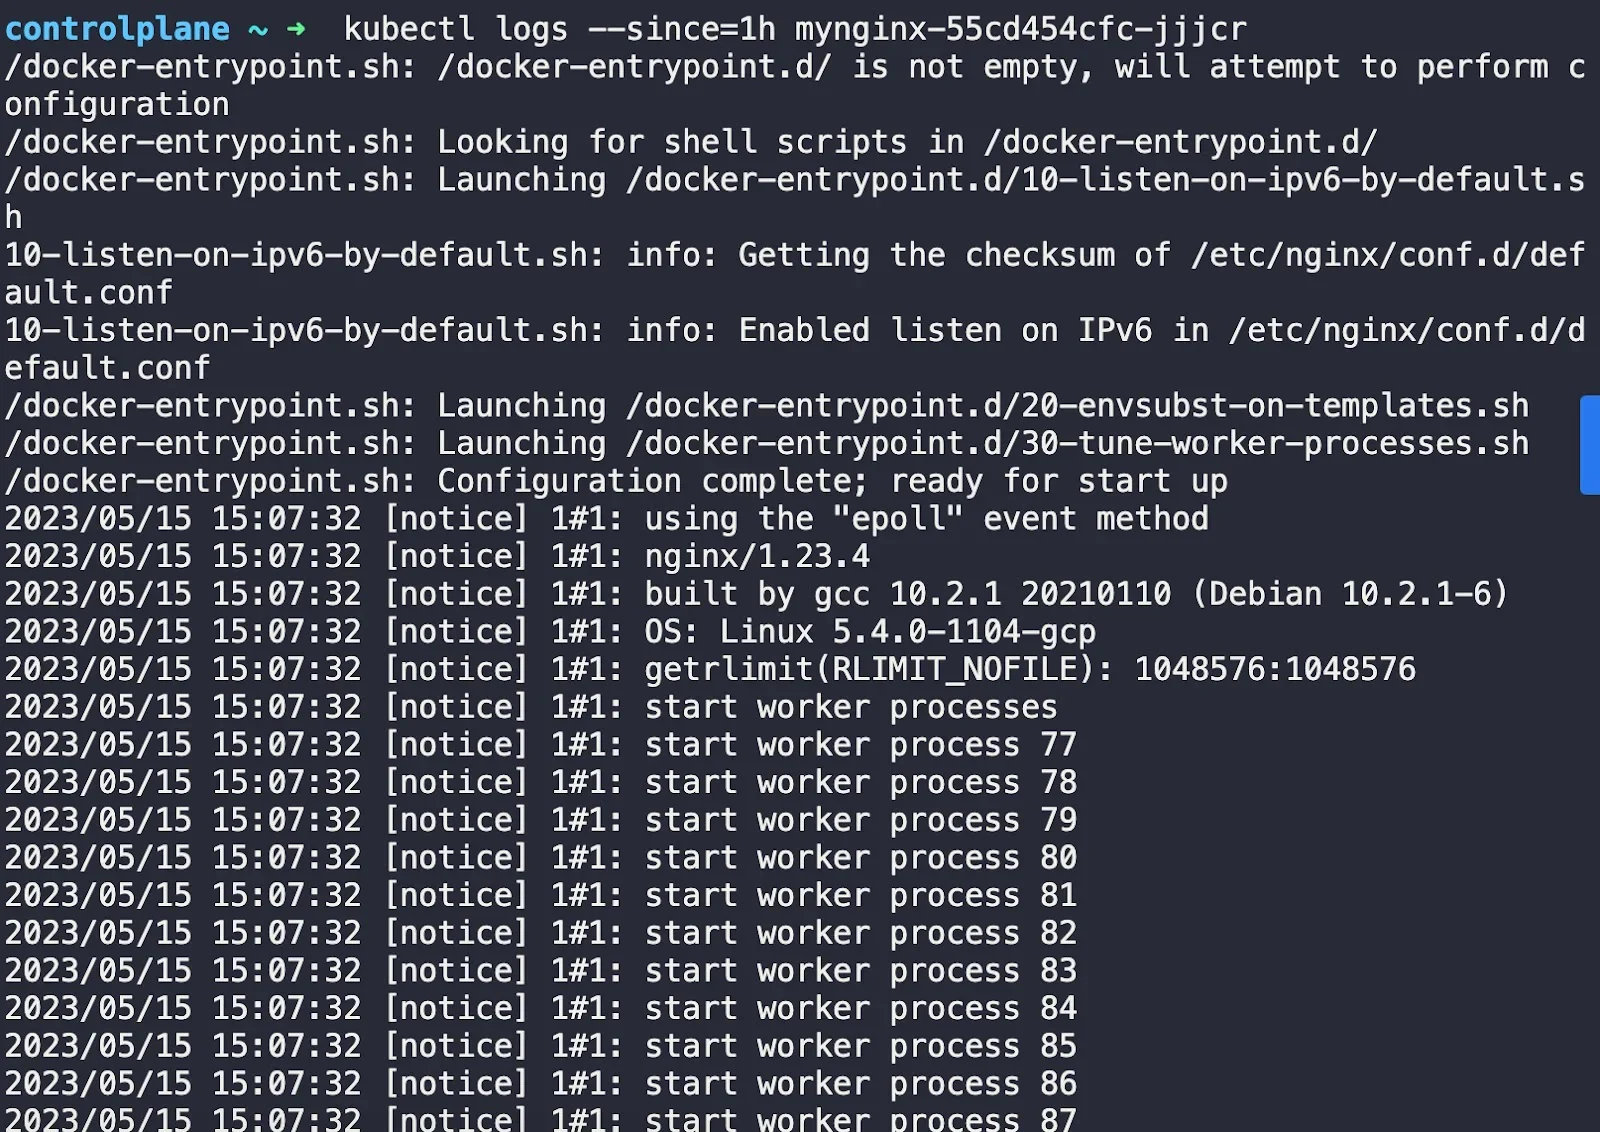
用kubectl logs筛选与追踪问题日志
在实际故障排查中,静态日志往往不够用,需结合动态参数精准定位。使用-f可开启实时流式跟踪,配合--tail 100仅加载最近百行,避免终端卡顿。--since 5m与--timestamps能按时间窗口过滤并附加时间戳,便于对齐业务事件。当容器因OOM或崩溃重启时,旧日志会被归档,此时必须添加--previous参数才能查看崩溃前的关键堆栈。针对多副本场景,可借助标签选择器批量拉取,如kubectl logs -l app=backend --tail=50会并行获取所有匹配Pod的最新日志。若需追踪特定节点或状态,可结合kubectl get pods -l app=backend -o name与xargs组合使用。这些参数组合能大幅缩小排查范围,尤其在灰度发布或滚动更新期间,可快速锁定异常实例的历史轨迹。
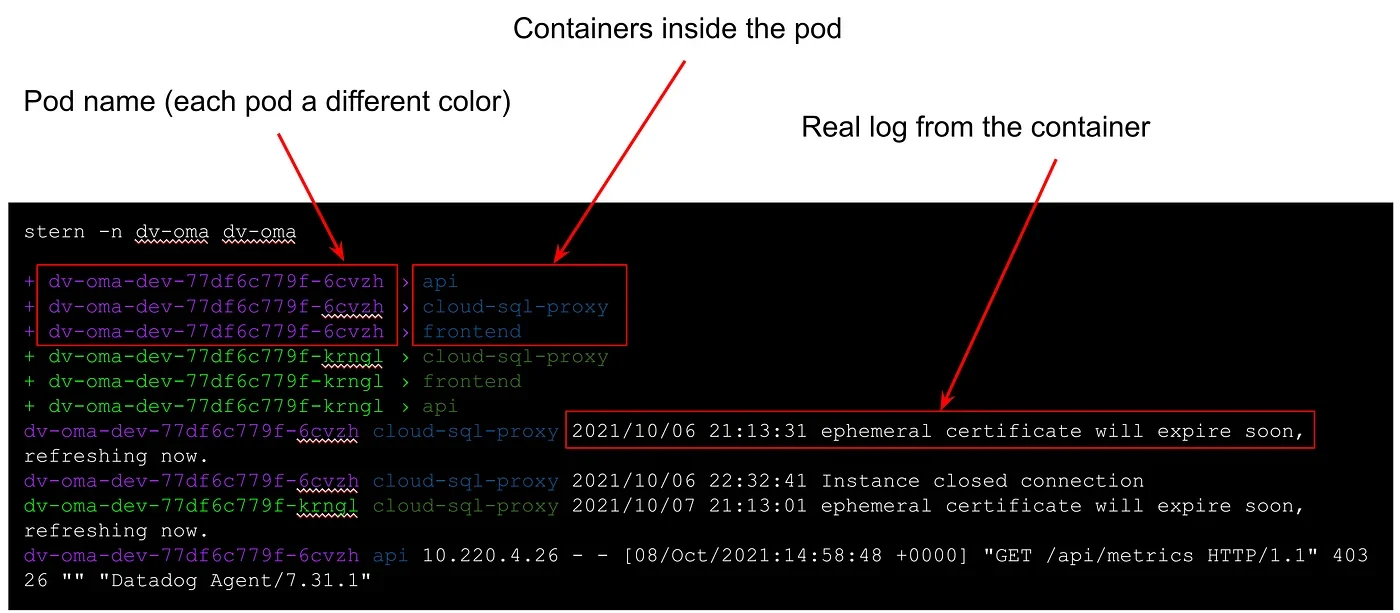
安装stern并聚合多个Pod实时日志
面对微服务架构中动辄数十个副本的部署,kubectl logs逐个查看的效率极低,且无法直观对比不同Pod的日志时序。stern作为开源命令行工具,专为解决此痛点而生。安装极为简便,macOS用户可通过brew install stern获取,Linux用户可直接下载二进制文件或使用go install github.com/stern/stern@latest。其核心优势在于支持正则表达式匹配Pod名称,例如stern "my-service-.*"会自动发现并聚合所有匹配Pod的实时日志流。通过-n production可限定命名空间,-l tier=frontend支持标签过滤。stern会在每行日志前自动添加[pod-name] [container-name]前缀,使多容器输出在同一终端中清晰可辨。无论是监控滚动更新进度,还是对比主备节点行为差异,stern都能提供连贯、低延迟的聚合视图。
过滤、格式化与避坑:让实时日志可读可控
日志聚合后若缺乏过滤,终端极易被海量信息淹没。stern提供--since 10m与--tail 20控制初始加载量,--exclude "healthcheck|ping"可屏蔽高频心跳日志,--include "ERROR|FATAL"则聚焦关键异常。通过--timestamps保留原始时间,--output json可将日志转为结构化格式便于管道处理。为避免API Server过载,建议使用--max-log-requests 50限制并发连接数。实际使用中需注意常见陷阱:Kubelet默认日志轮转策略为10MB×5份,超出部分将被丢弃,因此不能依赖kubectl logs追溯长期历史;RBAC权限不足会导致forbidden报错,需确保ServiceAccount具备pods/log读取权限;避免使用.*全量匹配,否则可能拖垮终端渲染性能。合理组合过滤规则与并发控制,方能在复杂集群中保持日志流的可读性与系统稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









