

数据库时序数据库:InfluxDB与Prometheus存储

理解 InfluxDB 与 Prometheus 的时序数据模型与存储机制
时序数据的核心在于按时间顺序记录指标变化。InfluxDB 采用 Measurement(类似表)、Tag(带索引的键值对)、Field(无索引的实际数值)与 Timestamp 的结构组织数据,其底层使用 TSM 引擎将数据按时间窗口分块压缩存储,并通过倒排索引加速 Tag 查询。Prometheus 则基于 Metric 名称、Label 与 Sample 构建数据模型,底层 TSDB 采用 Head Block 与持久化 Block 的分层设计,利用预写日志保证写入可靠性,并通过 Chunks 和 Index 文件实现高效范围扫描。两者在生命周期管理上差异显著:InfluxDB 依赖显式的保留策略自动清理过期数据,而 Prometheus 默认按时间窗口滚动删除旧 Block。理解这些底层结构是合理设计标签与规划存储容量的前提。
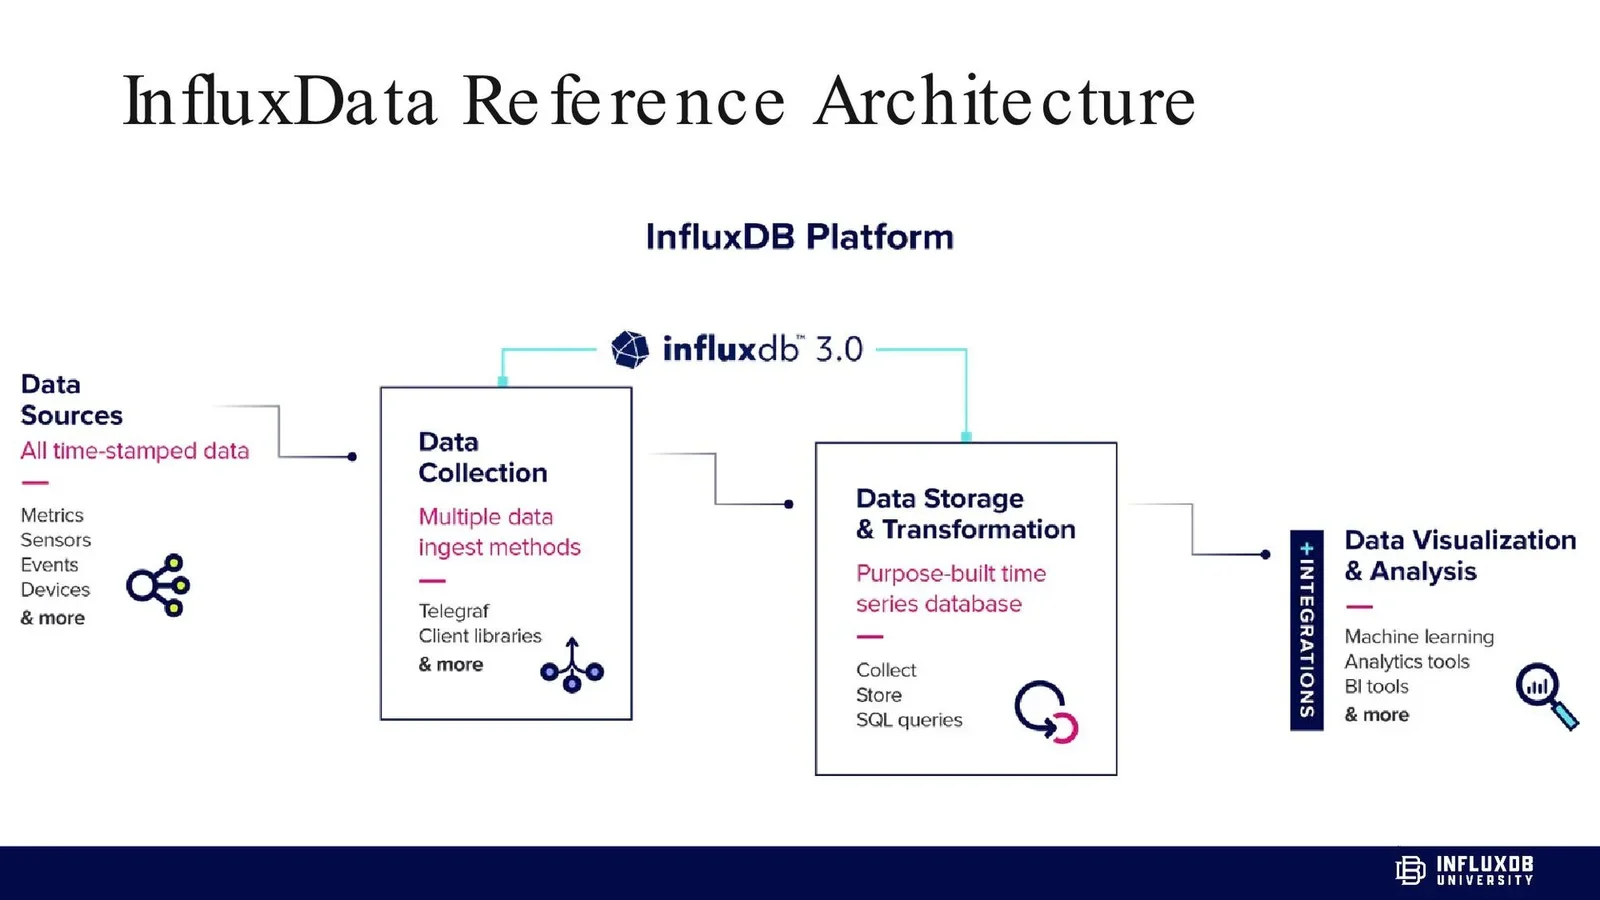
配置 InfluxDB 与 Prometheus 的数据写入和存储
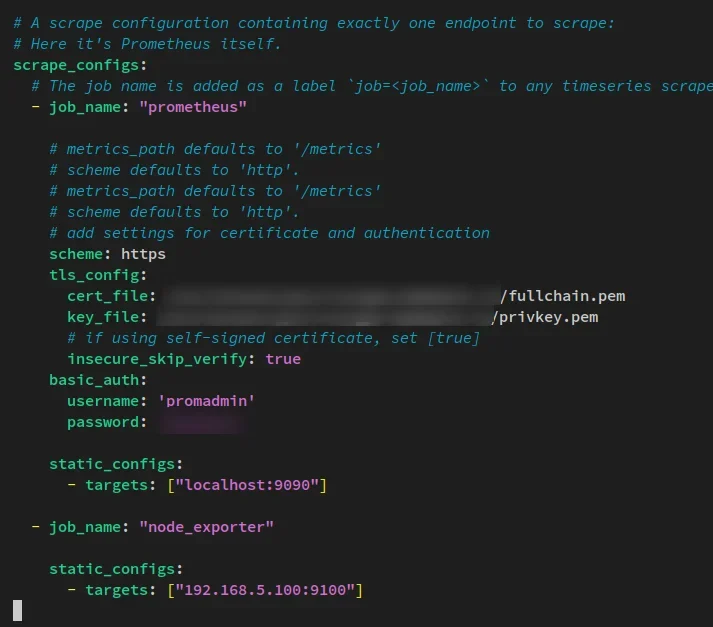
在 InfluxDB 中,需先创建 Bucket 并绑定保留策略。例如通过 CLI 执行 influx bucket create -n my_metrics -d 30d 可设定三十天保留期。写入数据通常使用行协议格式,如 cpu,host=server01 usage=0.75 1690000000000000000,可通过 Telegraf 或 HTTP API 批量推送。Prometheus 的写入依赖 scrape_configs,在 prometheus.yml 中配置目标地址与抓取间隔,如 scrape_interval: 15s 配合 targets 列表。其数据默认存储在指定目录,通过启动参数 storage.tsdb.retention.time 控制保留周期。需特别注意高基数标签会导致索引膨胀与内存溢出,实际配置时应将动态请求标识或用户 IP 等高基数维度剥离至日志系统或应用层聚合,避免拖垮存储引擎。
查询时序数据并验证存储结果
数据落盘后,需通过查询接口验证完整性。在 InfluxDB 中,可使用 Flux 语言进行检索,例如 from(bucket: my_metrics) |> range(start: -1h) |> filter(fn: (r) => r._measurement == cpu and r.host == server01) |> aggregateWindow(every: 5m, fn: mean) 可获取过去一小时按五分钟聚合的均值。Prometheus 则依赖 PromQL,在 Web UI 输入 rate(cpu_usage_seconds_total[5m]) 即可计算速率。验证时,应先写入已知测试样本,随后分别限定时间范围与标签条件执行查询,对比返回的样本数量与时间戳连续性。若查询结果缺失,需检查时间戳精度、写入延迟或 Block 压缩状态,确保数据已正确刷盘且未被过早清理。
对比存储性能、数据保留与典型使用场景
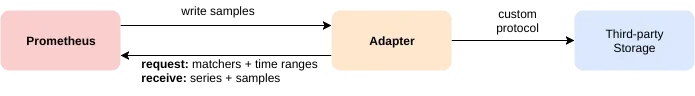
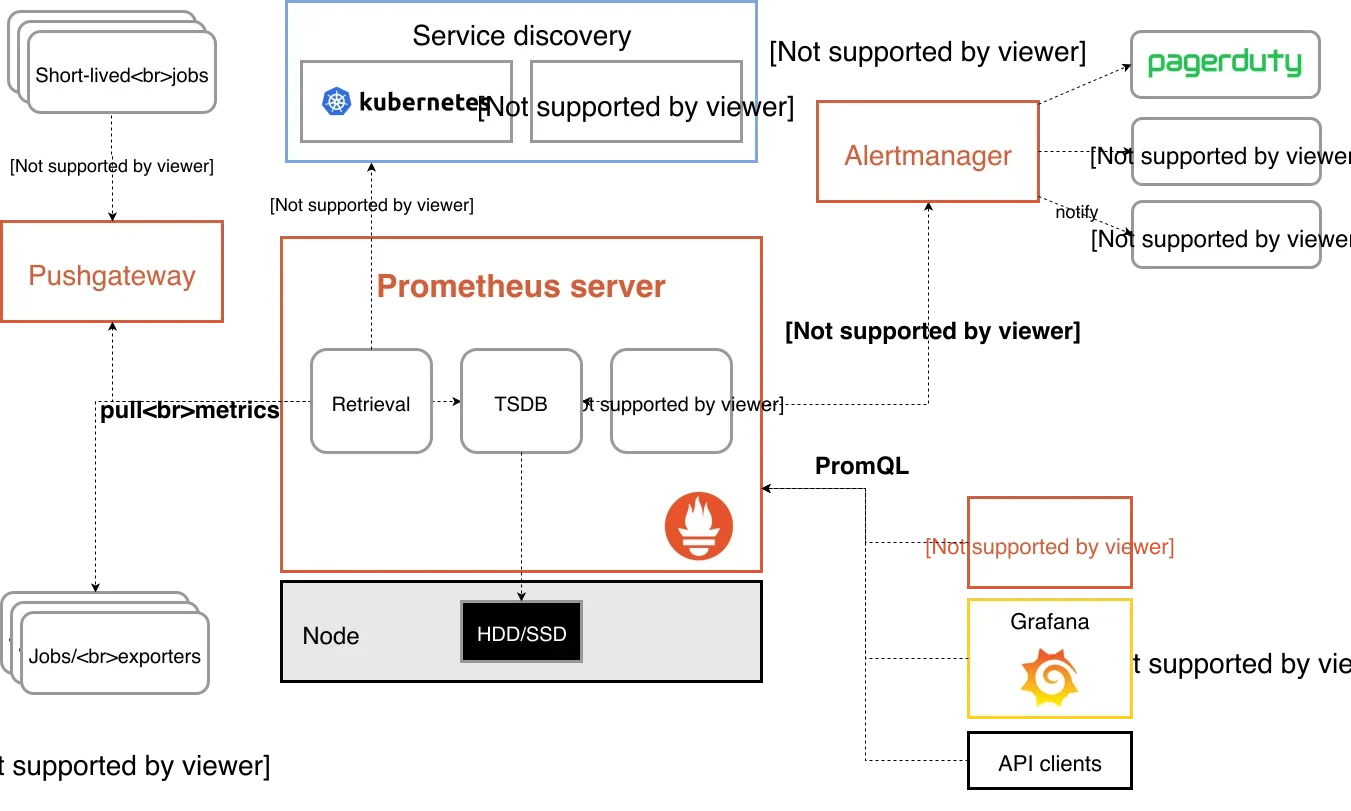
InfluxDB 与 Prometheus 在架构定位上各有侧重。Prometheus 采用拉取模型,专为云原生监控设计,其 TSDB 针对高频指标抓取与即时告警优化,内置服务发现与告警生态,但原生长期存储能力有限,通常需对接远程存储方案实现跨集群聚合与对象存储归档。InfluxDB 支持推送模型,写入吞吐更高,提供灵活的查询与丰富的数据转换能力,适合业务指标分析、物联网设备数据汇聚及自定义仪表盘构建。在数据压缩方面,InfluxDB 的引擎对浮点型字段压缩率极高,而 Prometheus 的压缩算法对单调递增计数器更友好。若场景以系统监控为主,Prometheus 是首选;若需长期留存与多维分析,InfluxDB 更为合适。
排查高基数、磁盘增长与数据丢失问题
实际运维中,时序数据库常因设计不当引发故障。Prometheus 的标签高基数会直接导致内存暴涨与索引碎片化,可通过内置指标监控序列数,并使用启动参数限制块大小,或引入重标签配置过滤无用维度。InfluxDB 若将随机字符串设为标签,同样会触发内存泄漏,应改用字段存储或定期执行压缩操作。磁盘空间不足多因保留策略设置过长或写入频率过高,可通过系统命令监控数据目录,并调整刷盘延迟参数优化性能。时间戳异常或重复写入会导致查询结果跳变,需确保客户端时钟同步并启用幂等写入。异常重启后,预写日志会重放未持久化数据,若日志损坏则可能丢失近期指标,建议配置定期快照与外部备份策略。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









