

Django ORM数据库操作完整指南:增删改查与高级查询

本文详细解析Django框架中的ORM数据库操作,涵盖数据新增、删除、修改及查询四大核心功能。重点讲解save与create方法的区别,filter与exclude的使用,以及exact、contains等过滤条件语法。同时深入介绍F对象、Q对象、聚合函数、排序及多对一/一对多关联查询的高级用法,帮助开发者掌握Django数据持久化核心技能。
本文通过具体实例深入解析Django框架中的ORM数据库操作,旨在为读者提供清晰的参考指南。
首先准备测试数据,主要涉及BookInfo(图书信息)表。
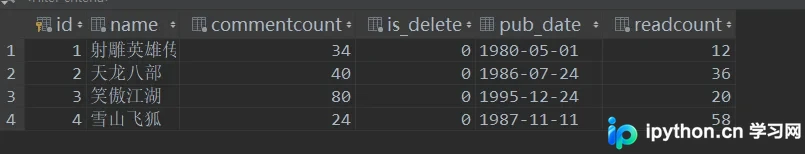
其次涉及PeopleInfo(人物信息)表,用于演示关联关系。
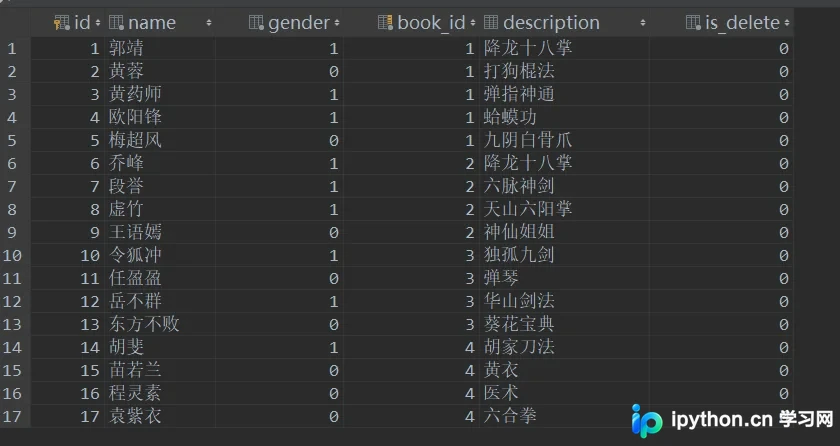
一.增加
1.save方法:
对象 = 模型类(
字段名 = 值,
字段名 = 值,
…
)
通过实例化对象后调用save()方法进行保存。
具体示例如下:
>>> book = BookInfo(
...     name='python入门',
...     pub_date='2010-1-1'
...   )
>>> book.save()
>>> book
<BookInfo: python入门>
2.create方法:
模型类.objects.create(
字段名 = 值,
字段名 = 值,
…
)
直接通过模型类的objects.create()创建并保存对象。
>>> PeopleInfo.objects.create(
...     name='itheima',
...     book=book
...   )
<PeopleInfo: itheima>
二.删除
1.通过模型类对象删除:
先使用get()获取特定对象,再调用delete()方法。 对象 = 模型类.objects.get(条件) 对象.delete()
具体示例如下:
>>> person = PeopleInfo.objects.get(name='传智播客')
>>> person.delete()
(1, {'book.PeopleInfo': 1})
2.通过模型类.objects.filter().delete()批量删除:
使用filter()筛选符合条件的对象集,直接调用delete()进行删除。
具体示例如下:
>>> BookInfo.objects.filter(name='python入门').delete()
(1, {'book.BookInfo': 1, 'book.PeopleInfo': 0})
三.修改
1.save方法:
先获取对象,修改其属性值,最后调用save()保存更改。 对象 = 模型类.objects.get(条件) 对象.属性 = 值 对象.save()
具体示例如下:
>>> person = PeopleInfo.objects.get(name='itheima')
>>> person.name = 'itcast'
>>> person.save()
>>> person
<PeopleInfo: itcast>
2.update方法:
使用filter()筛选对象集后调用update()直接更新属性,该方法返回受影响的行数。
具体示例如下:
>>> PeopleInfo.objects.filter(name='itcast').update(name='传智播客')
四.查询
1.基本查询
get:用于查询单一结果,若不存在则抛出DoesNotExist异常,若结果不止一个也会报错。 all:查询所有符合条件的多个结果。 count:统计结果的数量。
基本用法为:模型类.objects.get/all/count()。
2.过滤查询
filter:用于过滤出多个结果。 exclude:排除符合条件的数据,返回剩余结果。 get:用于过滤出单一结果。
3.过滤条件语法
用法格式为:属性名称__比较运算符 = 值。 exact:表示精确相等。
示例:查询编号为1的图书。
BookInfo.objects.filter(id__exact=1)
可以简写为直接指定属性值。
BookInfo.objects.filter(id=1)
contains:表示字符串包含指定子串。
示例:查询书名包含'传'字的图书。
BookInfo.objects.filter(name__contains='传')
<QuerySet [<BookInfo: 射雕英雄传>]>
startswith/endswith:分别表示以指定值开头或结尾。
示例:查询书名以'部'字结尾的图书。
>>> BookInfo.objects.filter(name__endswith='部')
<QuerySet [<BookInfo: 天龙八部>]>
isnull:判断字段是否为空。
示例:查询书名为空的图书。
>>> BookInfo.objects.filter(name__isnull=True)
<QuerySet []>
in:判断字段值是否在指定的列表中。
示例:查询编号为1、3或5的图书。
>>> BookInfo.objects.filter(id__in=[1,3,5])
<QuerySet [<BookInfo: 射雕英雄传>, <BookInfo: 笑傲江湖>]>
gt/gte/lt/lte:分别表示大于、大于等于、小于、小于等于的比较查询。
示例:查询编号大于3的图书。
>>> BookInfo.objects.filter(id__gt=3)
<QuerySet [<BookInfo: 雪山飞狐>]>
year/month/day/week_day/hour/minute/second:用于时间日期的特定字段查询。
示例:查询1980年发表的图书。
>>> BookInfo.objects.filter(pub_date__year=1980)
<QuerySet [<BookInfo: 射雕英雄传>]>
4.F对象和Q对象
F对象:用于在查询中比较两个字段属性(使用前需导入)。 用法:F(属性名) 示例:查询阅读量大于等于评论量的图书。
>>> from django.db.models import F
>>> BookInfo.objects.filter(readcount__gt=F('commentcount'))
<QuerySet [<BookInfo: 雪山飞狐>]>
Q对象:用于实现逻辑或(or)的查询。 用法:Q(属性名__运算符=值),也可在前面加~表示逻辑非(not)。 示例:查询阅读量大于20,或编号小于3的图书。
>>> BookInfo.objects.filter(Q(readcount__gt=20)|Q(id__lt=3))
<QuerySet [<BookInfo: 射雕英雄传>, <BookInfo: 天龙八部>, <BookInfo: 雪山飞狐>]>
5.聚合函数
聚合函数:可通过aggregate()过滤器调用聚合函数(Avg, Count, Max, Min, Sum)。 用法:模型类.objects.aggregate(聚合函数(字段名)) 示例:查询图书的总阅读量。
>>> from django.db.models import Sum
>>> BookInfo.objects.aggregate(Sum('readcount'))
{'readcount__sum': 126}
返回值为字典类型,格式为:{'属性名__聚合类小写':值}。
注意:使用count统计数量时,通常不需要使用过滤器。
示例:查询图书总数。
BookInfo.objects.count()
此时返回值为一个数字。
6.排序函数
用法:模型类.objects.all().order_by(属性名)。 默认按升序排序,若属性名前加-号则为降序。 示例:
# 默认升序
>>> BookInfo.objects.all().order_by('readcount')
<QuerySet [<BookInfo: 射雕英雄传>, <BookInfo: 笑傲江湖>, <BookInfo: 天龙八部>, <BookInfo: 雪山飞狐>]>
# 降序
>>> BookInfo.objects.all().order_by('-readcount')
<QuerySet [<BookInfo: 雪山飞狐>, <BookInfo: 天龙八部>, <BookInfo: 笑傲江湖>, <BookInfo: 射雕英雄传>]>
7.关联查询
一到多的访问:
用法:一对应的模型类对象.多对应的模型类名小写_set。 示例:查询id为1的书籍关联的所有人物。
>>> book = BookInfo.objects.get(id=1)
>>> book.peopleinfo_set.all()
<QuerySet [<PeopleInfo: 郭靖>, <PeopleInfo: 黄蓉>, <PeopleInfo: 黄药师>, <PeopleInfo: 欧阳锋>, <PeopleInfo: 梅超风>]>
多到一的访问:
用法:多对应的模型类对象.多对应的模型类中的关系类.属性名。 示例:查询id为1的人物所属的书籍。
>>> person = PeopleInfo.objects.get(id=1)
>>> person.book.name
‘射雕英雄传'
关联过滤查询:
用法:关联模型类名小写__属性名__条件运算符=值。 示例:查询图书,要求图书中人物的描述包含"八"。
>>> book = BookInfo.objects.filter(peopleinfo__description__contains='八')
>>> book
<QuerySet [<BookInfo: 射雕英雄传>, <BookInfo: 天龙八部>]>
示例:查询图书阅读量大于30的所有人物。
>>> people = PeopleInfo.objects.filter(book__readcount__gt=30)
>>> people
<QuerySet [<PeopleInfo: 乔峰>, <PeopleInfo: 段誉>, <PeopleInfo: 虚竹>, <PeopleInfo: 王语嫣>, <PeopleInfo: 胡斐>, <PeopleInfo: 苗若兰>, <PeopleInfo: 程灵素>, <PeopleInfo: 袁紫衣>]>
希望本文所述内容能对大家基于Django的Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









