

Python实战:开发在线小说语音阅读器

本文详解如何使用Python开发一款小说语音阅读器。通过百度AI开放平台获取语音合成API,结合requests和lxml从笔趣阁抓取小说章节,并利用pygame库实现内存中音频的实时播放。文章涵盖API配置、网页解析、音频参数设置及代码实现,帮助开发者快速构建本地听书工具。
项目背景与需求分析
前言
此前在书荒期间,我在喜马拉雅APP上发现了一部由主播演播的小说《大王饶命》。虽然听感有趣且轻松,但该平台仅开放前200章免费,后续章节需付费收听。单章费用为0.2元,全书共计1300多章,总计需支付约260元。此外,主播更新速度较慢,等待完整收听的时间成本过高。
因此,我转向寻找文字版小说。然而,阅读文字版需要手眼协调,难以兼顾其他事务,且无法缓解想要继续阅读的冲动。经过网络搜索,未找到其他免费音频资源。同时,以往常用的具备阅读功能的软件(如微信阅读、追书神器等)也逐渐转向收费模式。
面对这一困境,作为Python开发者,这显然难不倒我们。既然掌握了Python这一高效工具,不妨借此机会实践一下编程技能。
秉持“自己动手,丰衣足食”的理念,接下来将利用Python技术栈构建一个专属的小说阅读器。
语音合成技术选型
语音合成方案选择
实现文字转语音的核心在于语音合成技术。目前市面上较为成熟的方案包括讯飞和百度语音,本文选用百度语音合成API进行实现。
创建语音合成应用
首先,需注册百度账号并登录百度AI开放平台,在控制台创建一个新应用。
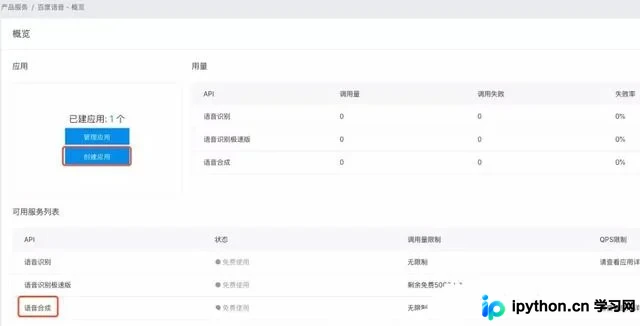
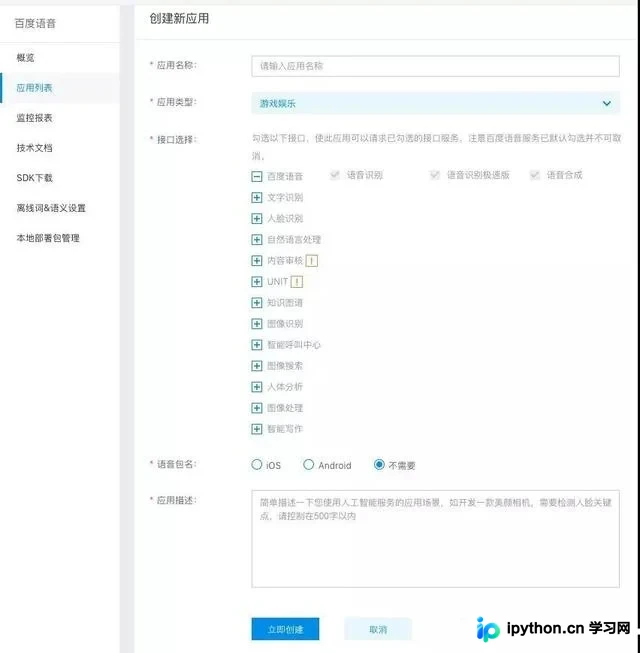
填写应用名称及描述信息后提交申请。
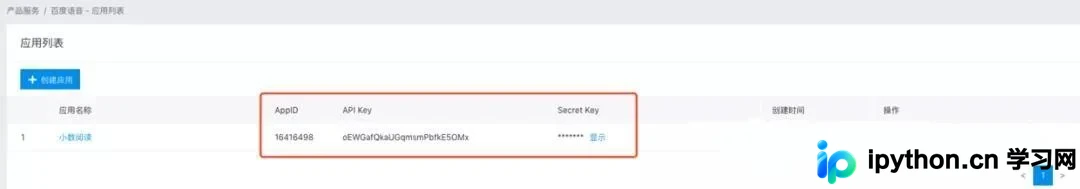
创建成功后,务必记录AppID、API Key和Secret Key,这些凭证将在调用API时使用。同时,查阅相关技术文档以了解接口规范。
通过命令pip install baidu-aip安装百度AI Python SDK。文档中提供了详细的示例代码,便于快速上手。SDK支持调节音量、语调、语速及发声人等参数。至此,语音合成环节已准备就绪,下一步是获取小说文本内容。
小说数据抓取与解析
小说内容获取策略
小说数据源选取自笔趣阁网站,主要考量因素为内容免费且反爬机制较弱。首先定位到目标小说的首页地址。
以链接https://www.biquge.info/40_40289/为例,使用requests库发起HTTP请求即可获取页面数据。对页面结构进行简要分析。
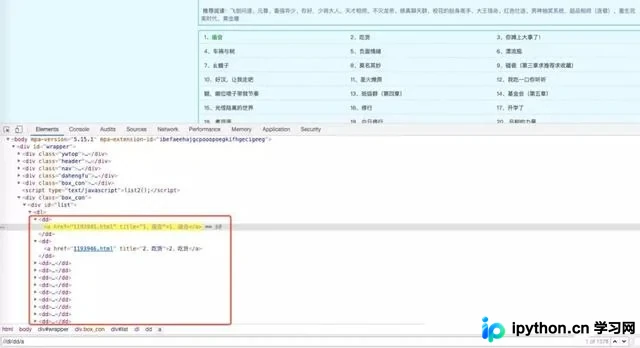
所有章节链接均位于dl标签下的dd元素中,且链接结构具有规律性,可直接使用xpath提取所有章节列表信息。
def get_chapters(self):
 url = "https://www.biquge.info/40_40289/"
 r = self.session.get(url)
 r.encoding = chardet.detect(r.content).get("encoding", "utf-8")
 html = etree.HTML(r.text)
 for item in html.xpath("//dl/dd/a"):
 yield item.attrib["title"], url + item.attrib["href"]
章节具体内容的获取逻辑相对简单,此处不再赘述。
def get_content(self, url):
 r = self.session.get(url)
 r.encoding = chardet.detect(r.content).get("encoding", "utf-8")
 html = etree.HTML(r.text)
 title = html.xpath(r'//*[@class="bookname"]/h1')[0].text
 for info in html.xpath("//div[@id='content']"):
 text = info.xpath("string(.)")
需注意,提取的章节内容中可能包含HTML标签。xpath提供的string(.)函数可有效提取多个子节点的纯文本,非常实用。
音频合成与播放实现
语音合成与数据存储
将获取的小说内容与语音合成模块结合,即可形成小说阅读器的基本雏形。基础实现逻辑如下:
import chardet
import requests
from lxml import etree
from aip import AipSpeech
class CollectNovels:
 def __init__(self):
 self.session = requests.session()
 self.session.headers["user-agent"] = "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36"
 """ 你的 APPID AK SK """
 APP_ID = '16416498'
 API_KEY = 'oEWGafQkaUGqmsmPbfkE5OMx'
 SECRET_KEY = '6jdsUcH0PXz5TYoELU47u58W5vPV9lwf'
 self.client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)
 def get_chapters(self, url):
 r = self.session.get(url)
 r.encoding = chardet.detect(r.content).get("encoding", "utf-8")
 html = etree.HTML(r.text)
 for item in html.xpath("//dl/dd/a"):
 yield item.attrib["title"], url + item.attrib["href"]
 def get_content(self, url):
 r = self.session.get(url)
 r.encoding = chardet.detect(r.content).get("encoding", "utf-8")
 html = etree.HTML(r.text)
 for info in html.xpath("//div[@id='content']"):
 text = info.xpath("string(.)")
 for line in text.split("。"):
 content = self.client.synthesis(line, 'zh', 1, {"per": 0})
 with open("auido.mp3", "rb") as fp:
 fp.write(content)
if __name__ == '__main__':
 novel = CollectNovels()
 home_url = "https://www.biquge.info/40_40289/"
 for title, url in novel.get_chapters(home_url):
 novel.get_content(url)
上述代码生成mp3文件,按行生成后通过合成软件处理,虽可存储于任意位置播放,但存在需预先完整生成才能播放的缺陷,使用体验不够便捷。若能实现边生成边播放,体验将更佳。
实时播放合成语音方案
推荐使用Python的pygame库进行音频播放。其他几个音频库要么效果不佳,要么已长期未维护,故不予采用。
import time
import pygame
from io import BytesIO
pygame_mixer = pygame.mixer
pygame_mixer.init(frequency=frequency)
byte_obj = BytesIO()
byte_obj.write(content)
byte_obj.seek(0, 0)
pygame_mixer.music.load(byte_obj)
pygame_mixer.music.play()
while pygame_mixer.music.get_busy():
 time.sleep(0.1)
pygame_mixer.stop()
利用BytesIO类将语音合成的二进制数据存储在内存中,从而避免生成本地mp3文件,节省磁盘空间。
关键注意点:调用pygame_mixer.init(frequency=frequency)时,必须设置frequency参数。若不设置,默认频率为22050,导致播放音质与mp3差异巨大。此前因怀疑库有问题而尝试多个库,最终发现需调整此参数。该参数值可从之前生成的mp3文件属性中获取。
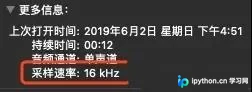
将频率参数设置为16000即可获得较好音质。
以上即为本文的全部内容,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









