


在 Go Web 开发里,Gin 的路由性能一直是它最容易被提起的优点之一。很多人知道它快,却不一定清楚快在哪里。真正起作用的不是某个“黑盒优化”,而是路由底层采用的前缀树结构,以及围绕这个结构做的路径压缩、通配符处理和优先级调整。看懂这些细节后,你不仅能理解 Gin 为何适合大规模 API,也更容易判断什么样的路由设计能把这套机制的优势发挥出来。
前缀树为什么适合做路由匹配
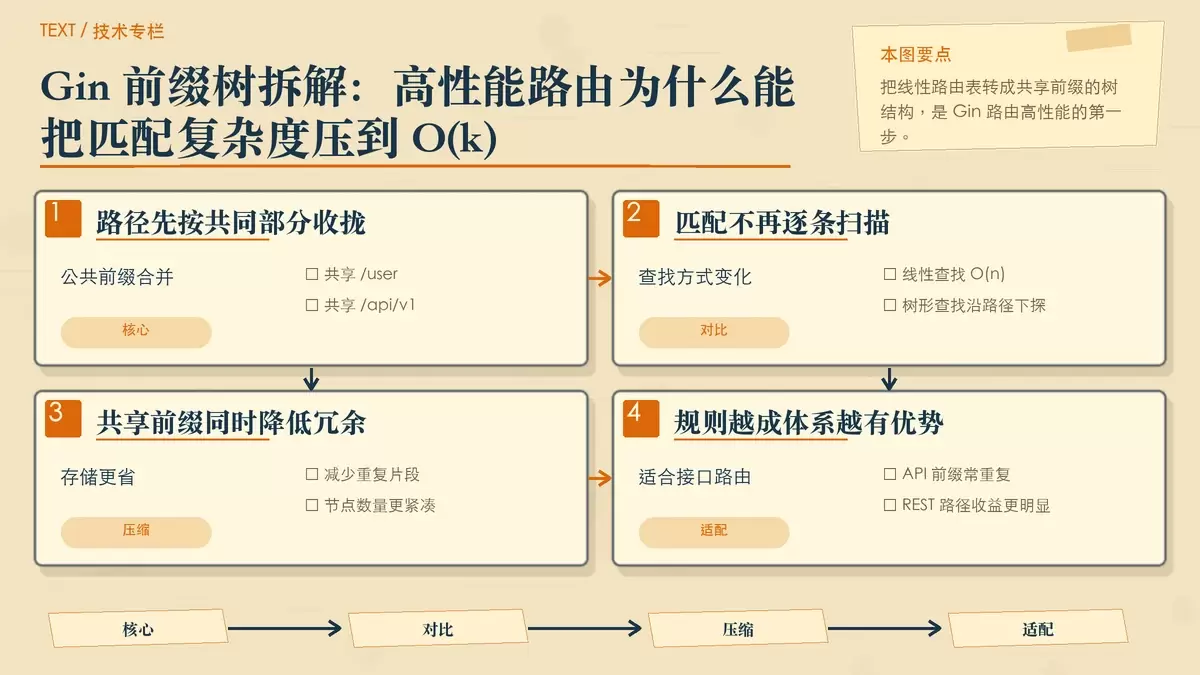
传统 Web 路由如果按列表顺序逐条比对,查找复杂度通常是 O(n)。当应用里有成百上千条路由时,请求越多、规则越复杂,匹配成本就越明显。
前缀树(Radix Tree)也叫压缩前缀树或基数树,它的思路不是把每条路由独立保存,而是先把公共前缀合并起来。这样既减少重复存储,也把原本“从头遍历整个路由表”的过程,变成“沿着路径逐段向下查找”的过程。
路由列表:
/user/profile
/user/settings
/api/v1/users
/api/v1/posts
/admin/dashboard以上这些路径放进前缀树后,/user 会成为一段共享前缀,/api/v1 也会被提取出来。匹配 /user/profile 时,不需要再把它和所有路由逐个比较,只要先进入 /user 这条分支,再继续匹配 profile 即可。
这也是前缀树特别适合 API 场景的原因:很多接口天然带有共同的路径前缀,比如 /api、/v1、/users,共享部分越多,树结构的收益越明显。
Gin 的路由实现借鉴了什么
Gin 的路由系统借鉴了 httprouter 的设计思想,但并不是简单封装。它在自己的 tree.go 中实现了完整的 Radix Tree 逻辑,并结合中间件链做了适配和优化。
httprouter 是 Go 生态里较早成熟的前缀树路由库,Gin、Chi 等主流框架都吸收了它的设计理念。核心点在于,匹配过程不依赖反射,也不走正则主导的重型方案,而是依靠基数树做字符级路径查找。
这种方式带来的直接结果是:路由匹配复杂度更接近 O(k),其中 k 是请求路径长度,而不是路由总数。也就是说,影响查找成本的主要是当前 URL 有多长,而不是系统里注册了多少条路由。
httprouter 的一个关键设计是:按 HTTP 方法分别维护前缀树。也就是 GET、POST、PUT、DELETE 等请求,各自对应一棵树。请求到来后,先按方法找到对应的树,再在树内继续做路径匹配。这样可以减少无关路由的干扰,也让树结构更紧凑。
前缀树节点里有哪些关键字段
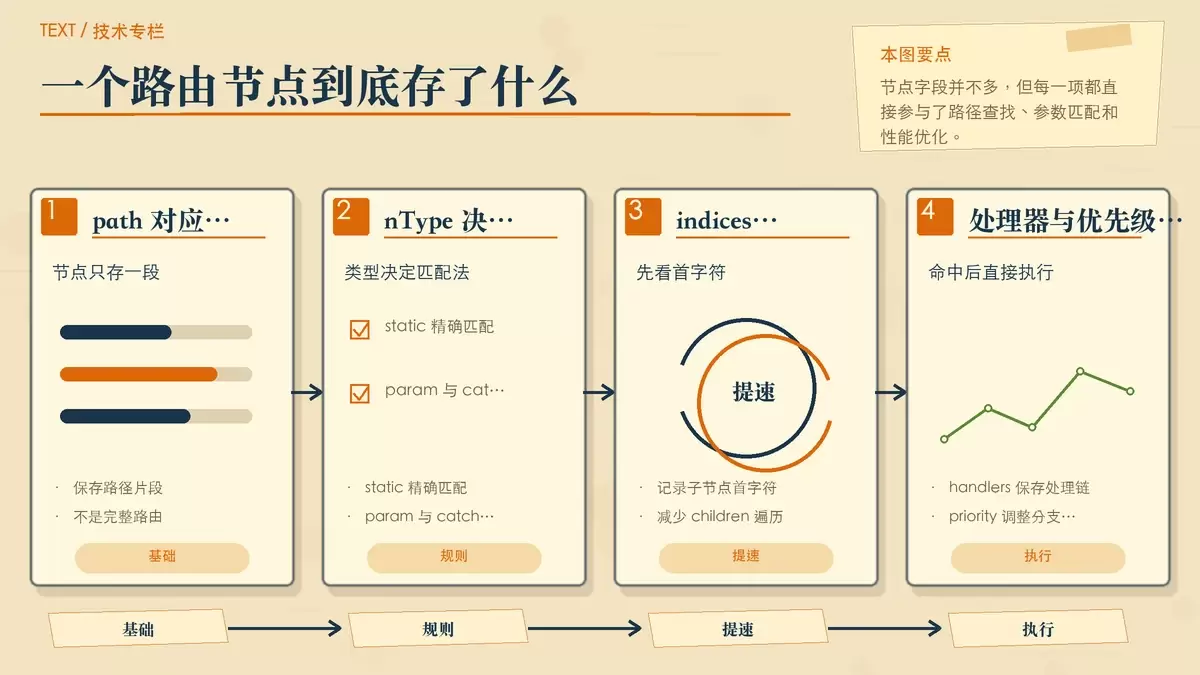
理解 Gin 或 httprouter 的路由实现,重点要看节点本身保存了什么信息。典型节点结构如下:
type node struct {
    path      string        // 当前节点的路径片段
    wildChild bool          // 是否有通配符子节点
    nType     nodeType      // 节点类型(静态、参数、通配符)
    indices   string        // 子节点首字符索引
    children  []*node       // 子节点列表
    handlers  HandlersChain // 匹配的处理器链(支持中间件)
    priority  uint32        // 优先级,用于优化
}
这些字段里,最值得关注的是以下几项:
path:保存当前节点对应的路径片段
它不是完整路由,而是压缩后的某一段路径。前缀树会尽量把连续、没有分叉的路径合并起来,所以一个节点保存的可能是 /user,也可能是更长的一段片段。
nType:决定节点按什么规则匹配
节点类型会直接影响匹配行为,常见的有:
- static:静态路径,精确匹配,如
/users - param:参数路径,如
/users/:id - catchAll:通配符路径,如
/users/*filepath - root:根节点
wildChild:标记是否存在通配符子节点
这个字段是布尔值。如果为 true,说明当前节点下面有参数路由或通配符路由,匹配时需要进入对应的特殊分支处理。
indices 和 children:一起决定如何快速下探
children 保存所有子节点,而 indices 保存这些子节点路径片段的首字符索引。两者配合后,匹配时不必每次完整遍历全部子节点,而是可以先用首字符快速缩小范围。
handlers 和 priority:一个负责执行,一个负责加速
handlers 保存命中的处理器链,这也是 Gin 能顺带把中间件链整合进路由节点的基础。priority 则用于调节子树顺序,让更常用、命中更多的分支优先参与匹配。
前缀树真正高效的地方还不止于“树形结构”,还在于路径压缩。比如同时插入 /user 和 /users,并不会机械地为每个字符都建一个节点,而是把 /user 作为共享前缀保留下来,再单独分出 /s 这个分支。这样能减少节点数量,让树更紧凑。
一次路由匹配到底是怎么走的
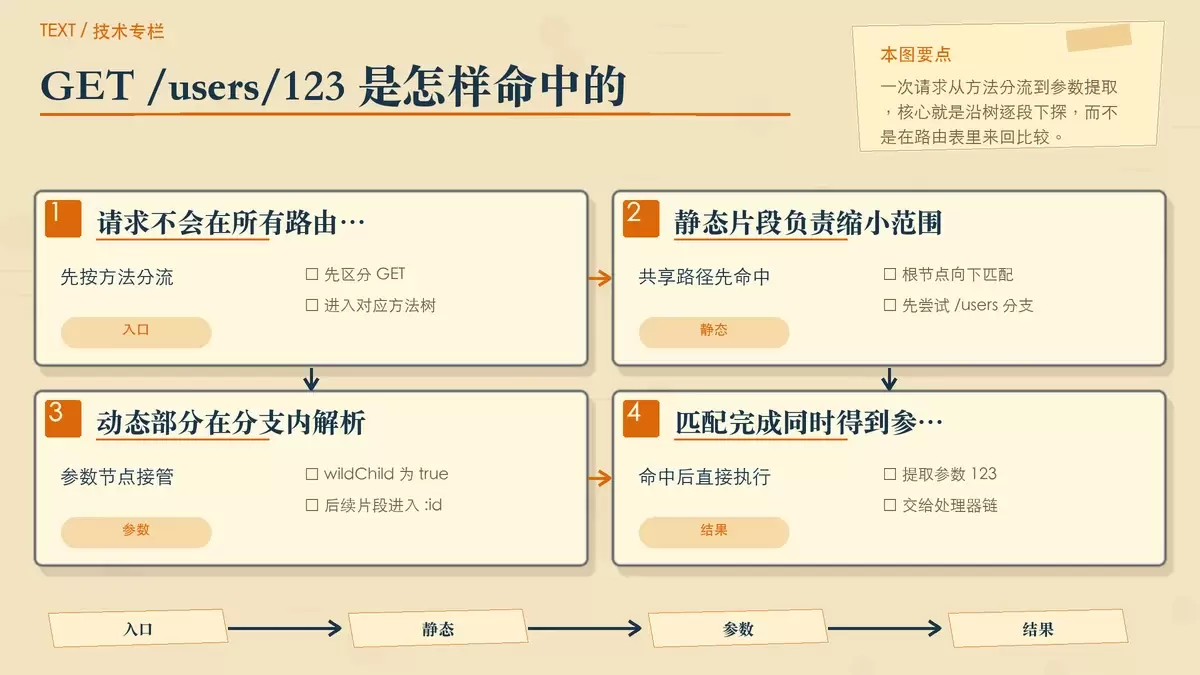
以请求 GET /users/123 为例,匹配过程通常可以拆成几步来看。
先按 HTTP 方法选中对应的树
请求是 GET,框架就先进入 GET 这棵前缀树,而不是在所有方法的路由里一起查找。
从根节点开始做字符级匹配
路由匹配从根节点向下进行,根据当前路径片段的首字符,尝试找到对应分支,然后继续比较后续字符。
静态分支优先,参数分支按规则接管
如果某个节点存在静态子节点,通常会先尝试精确匹配;如果 wildChild 为 true,说明还有参数路由或通配符路由可走,这时再切换到参数匹配逻辑。
例如 /users/:id 中的 :id,会在匹配到 /users 之后,把后续这一段当作参数提取出来。若路径里出现 * 通配符,则会把剩余所有内容一次性接收下来。
indices 用于减少无效遍历
假设某个节点下面有 /blog、/support、/search 三个子节点,那么 indices 可能就是 "bss"。它记录的是每个子节点路径首字符,匹配时可以先根据首字符定位目标分支,而不是把整个 children 数组从头扫一遍。
priority 继续压缩平均匹配成本
Gin 还加入了优先级优化。优先级通常会结合子树中的处理函数数量来计算,更常命中的路由分支会被放在更靠前的位置。这样做不会改变匹配结果,但能进一步降低平均查找成本。
用一段代码直观看前缀树如何工作
下面的示例使用 httprouter 演示,Gin 的思路与它相近:
package main

import (
    "fmt"
    "net/http"
    "github.com/julienschmidt/httprouter"
)

func main() {
    router := httprouter.New()

    // 注册路由:静态路径和参数路径
    router.GET("/users", func(w http.ResponseWriter, r *http.Request, _ httprouter.Params) {
        w.Write([]byte("list users"))
    })
    router.GET("/users/:id", func(w http.ResponseWriter, r *http.Request, ps httprouter.Params) {
        w.Write([]byte("user: " + ps.ByName("id")))
    })

    fmt.Println("Server starting on :8080")
    http.ListenAndServe(":8080", router)
}
这段代码里注册了两条 GET 路由:一条是静态路径 /users,另一条是参数路径 /users/:id。框架会自动把它们组织进同一棵前缀树中,因为它们共享了 /users 这一段前缀。
当访问 GET /users/123 时,匹配过程会先锁定 GET 路由树,再找到 /users 这段共享路径,接着进入参数节点,把 123 提取为 id。开发者写代码时只看到一条参数路由,底层实际已经完成了树化组织和参数解析。
这也是为什么前缀树方案很适合 RESTful API:同一资源往往共享一段稳定前缀,像 /users、/users/:id、/users/:id/posts 这样的路径,天然容易被压缩和复用。
性能优势在哪,什么场景最能体现价值
前缀树路由相较于传统方案,优势主要体现在三个方面。
查找复杂度更稳定
单次查找复杂度是 O(k),核心取决于路径长度,与路由总数关系较弱。即使系统里有上万条路由,请求匹配速度也不会像线性扫描那样明显下滑。
共享前缀能减少重复存储
对于大量路径相似的 API,前缀树能把公共部分合并掉,减少重复节点和重复字符串存储,内存利用率更高。
避免正则表达式带来的额外损耗
整个匹配过程主要是字符比较和树节点跳转,不需要把大量路径判断交给正则引擎,因此在高并发场景下更容易保持稳定。
当然,这种结构也不是在所有场景都能压出同样的收益。如果路径规则非常随机、前缀共享很少,压缩效果就不会特别明显。但对大多数 Web 应用,尤其是 RESTful API 服务来说,前缀树依然是很理想的路由实现方式。
从使用角度看,理解这一点还有一个实际价值:设计 API 时尽量保持路径层次清晰、命名一致,不只是可读性更好,也更符合前缀树的组织方式。换句话说,合理的路由结构既服务团队协作,也能顺带服务底层性能。
理解 Gin 路由性能的一个关键抓手
Gin 的高性能路由,并不是简单来自“实现得更快”,而是来自前缀树这套结构化思路。共享前缀、路径压缩、参数节点、通配符节点,再加上按方法分树和优先级优化,共同把路由匹配控制在 O(k) 级别。
理解这个原理后,再看 Gin 的路由注册方式就会更清楚:为什么相似路径组织得越规整,底层越容易高效匹配;为什么参数路由和通配符路由需要遵守一定规则;也为什么 Gin、Chi 等框架会长期采用这类设计。它不只是一个实现细节,而是高性能 Web 路由背后的核心方法。









