

使用Python和Splinter实现Web门户自动登录

发布时间:2026-10-13| 6人浏览过
本文介绍如何利用Python3结合Splinter库实现Web门户的自动登录。内容涵盖环境准备、浏览器驱动指定(如Firefox或Chrome)、HTML属性修改及多线程处理等关键步骤,并提供完整的代码示例与注意事项,帮助开发者快速掌握Web自动化登录技术。
借助Python语言,可以编写脚本填充网页表单,进而实现Web门户的自动登录操作。
(注:以下说明仅适用于Python3环境)
环境配置要求:
(1)安装Python解释器; (2)安装Splinter库,可通过下载源码并执行 python setup install 命令完成安装。
#coding=utf-8
import time
from splinter import Browser

def login_mail(url):
  browser = Browser()
  #login 163 email websize
  browser.visit(url)
  #wait web element loading
  #fill in account and password
  browser.find_by_id('username').fill('你的用户名称')
  browser.find_by_id('password').fill('你的密码')
  #click the button of login
  browser.find_by_id('loginBtn').click()
  time.sleep(5)
  #close the window of brower
  browser.quit()

if __name__ == '__main__':
  mail_addr ='http://reg.163.com/'
  login_mail(mail_addr)
提示:
(1)若需修改网页HTML属性,可执行JavaScript代码。
browser.execute_script('document.getElementById("Html属性ID").value = "在此提供默认值"')
(2)初始化浏览器对象时,代码为:browser = Browser()
若不指定具体浏览器,默认使用Firefox驱动;也可指定其他浏览器,例如:browser = Browser('chrome'),此时需下载并配置对应的浏览器驱动程序。
1. Python3浏览网页页面
#coding=utf-8
import urllib.request
import time
#在请求加上头信息,伪装成浏览器访问
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:23.0) Gecko/20100101 Firefox/23.0'}
chaper_url='http://XXX'

vist_num=1
while vist_num<1000:
 if vist_num%50==0:
  time.sleep(5)
 print("This is the 【 "+str(vist_num)+" 】次尝试")
 req = urllib.request.Request(url=chaper_url, headers=headers)
 urllib.request.urlopen(req).read() #.decode('utf-8')
 vist_num+=1
2. Python多线程处理
#coding=utf-8
import threading #导入threading包
from time import sleep
import time

def fun1():
  print ("Task 1 executed." )
  time.sleep(3)
  print ("Task 1 end." )

def fun2():
  print ("Task 2 executed." )
  time.sleep(5)
  print ("Task 2 end." )

threads = []
t1 = threading.Thread(target=fun1)
threads.append(t1)
t2 = threading.Thread(target=fun2)
threads.append(t2)

for t in threads:
  # t.setDaemon(True)
  t.start()
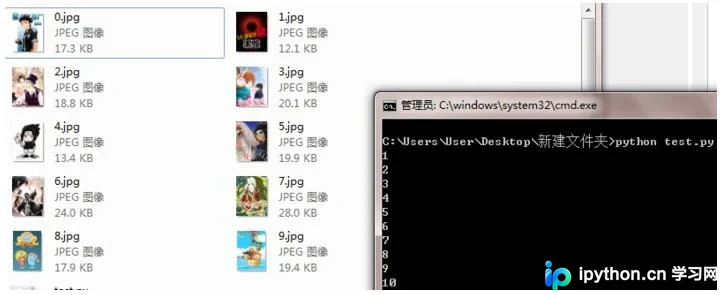
3. 利用Python下载百度图片
#coding=utf-8
import urllib.request
import re

def getHtml(url):
  page = urllib.request.urlopen(url)
  html = page.read()
  return html

def getImg(html):
  reg = r'src="(.+?\.jpg)"'
  imgre = re.compile(reg)
  html=html.decode('utf-8')
  imglist = re.findall(imgre,html)
  x = 0
  for imgurl in imglist:
    urllib.request.urlretrieve(imgurl,'%s.jpg' % x)
    x+=1
    print(str(x))

html = getHtml("http://image.baidu.com/channel?c=%E6%91%84%E5%BD%B1&t=%E5%85%A8%E9%83%A8&s=0")

print(getImg(html))
运行效果:
官方网站:链接地址
官方示例程序:链接地址
以上内容为本文的全部介绍,希望能为各位的学习提供便利,同时也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









