

Python实现最长公共子串与最长公共子序列算法详解

发布时间:2026-10-13| 3人浏览过
本文详细解析Python中求解最长公共子串(LCS)与最长公共子序列(LCSub)的方法。通过构建矩阵记录字符匹配状态,利用动态规划思想回溯路径,分别实现了获取连续最长子串及非连续最长子序列的功能,并附带完整代码示例与运行结果分析。
最长公共子串(The Longest Common Substring)
最长公共子串问题旨在寻找两个字符串中长度最长的连续公共部分。解决思路是构建一个二维矩阵,用于记录两个字符串在各个位置上的字符匹配情况:若字符匹配则标记为1,否则为0。随后,通过寻找矩阵中对角线上最长的连续1序列,即可确定最长匹配子串及其在原始字符串中的位置。
def find_lcsubstr(s1, s2):
 m=[[0 for i in range(len(s2)+1)] for j in range(len(s1)+1)] #生成0矩阵,为方便后续计算,比字符串长度多了一列
 mmax=0  #最长匹配的长度
 p=0 #最长匹配对应在s1中的最后一位
 for i in range(len(s1)):
 for j in range(len(s2)):
  if s1[i]==s2[j]:
  m[i+1][j+1]=m[i][j]+1
  if m[i+1][j+1]>mmax:
   mmax=m[i+1][j+1]
   p=i+1
 return s1[p-mmax:p],mmax  #返回最长子串及其长度

print find_lcsubstr('abcdfg','abdfg')
执行上述算法后,得到的输出结果为:('dfg',3)
最长公共子序列(The Longest Common Subsequence)
与子串要求字符必须连续不同,子序列中的字符无需连续。最长公共子序列在实际应用中价值显著,常用于衡量两段文本的“相似度”或雷同程度,进而辅助识别抄袭行为。此外,通过计算修改前后文本的最长公共子序列,并提取该序列之外的部分,可以精准定位文本的具体修改内容,这种方法在差异判断中往往具有较高的准确性。 算法实现采用动态规划思想:首先构建一个矩阵记录两个字符串的匹配状态,若字符匹配,则该位置的值等于其左上角位置的值加1;若不匹配,则取左侧和上方位置的最大值。同时,构建另一个矩阵记录状态转移的方向,最后根据该方向矩阵回溯,即可找到最长公共子序列。
import numpy
def find_lcseque(s1, s2):
 # 生成字符串长度加1的0矩阵,m用来保存对应位置匹配的结果
 m = [ [ 0 for x in range(len(s2)+1) ] for y in range(len(s1)+1) ]
 # d用来记录转移方向
 d = [ [ None for x in range(len(s2)+1) ] for y in range(len(s1)+1) ]

 for p1 in range(len(s1)):
 for p2 in range(len(s2)):
  if s1[p1] == s2[p2]:      #字符匹配成功,则该位置的值为左上方的值加1
  m[p1+1][p2+1] = m[p1][p2]+1
  d[p1+1][p2+1] = 'ok'
  elif m[p1+1][p2] > m[p1][p2+1]: #左值大于上值,则该位置的值为左值,并标记回溯时的方向
  m[p1+1][p2+1] = m[p1+1][p2]
  d[p1+1][p2+1] = 'left'
  else:              #上值大于左值,则该位置的值为上值,并标记方向up
  m[p1+1][p2+1] = m[p1][p2+1]
  d[p1+1][p2+1] = 'up'
 (p1, p2) = (len(s1), len(s2))
 print numpy.array(d)
 s = []
 while m[p1][p2]:  #不为None时
 c = d[p1][p2]
 if c == 'ok':  #匹配成功,插入该字符,并向左上角找下一个
  s.append(s1[p1-1])
  p1-=1
  p2-=1
 if c =='left': #根据标记,向左找下一个
  p2 -= 1
 if c == 'up':  #根据标记,向上找下一个
  p1 -= 1
 s.reverse()
 return ''.join(s)
print find_lcseque('abdfg','abcdfg')
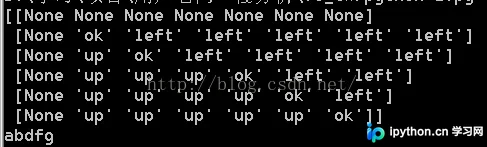
算法执行后得到的输出结果如下:
以上内容为本文的全部介绍,希望能为读者的学习提供有益的帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









