

Python读取指定文件夹下所有图像并构建数据集的方法

发布时间:2026-10-14| 6人浏览过
本文介绍如何使用Python批量读取指定文件夹下的所有图像,并将其转换为numpy的ndarray格式以构建数据集。文中详细说明了通过文件名解析标签的逻辑,展示了如何定义加载函数以返回包含图像数据和对应标签的数组,并给出了具体的调用示例。该方法适用于需要将图像文件转换为多维数组以进行后续机器学习或深度学习模型训练的场景。
数据准备与数据集介绍
数据准备阶段
数据集介绍
该数据集共包含1223幅图像。其中,负样本有756个,图像命名格式为0.1至0.756;正样本有458个,图像命名格式为1.1至1.458。在文件名中,小数点前的数字代表样本标签,小数点后的数字代表样本序号。
Python批量读取图像实现
利用Python读取文件夹中所有图像
核心加载函数定义
'''
Load the image files form the folder
input:
  imgDir: the direction of the folder
  imgName:the name of the folder
output:
  data:the data of the dataset
  label:the label of the datset
'''
def load_Img(imgDir,imgFoldName):
  imgs = os.listdir(imgDir+imgFoldName)
  imgNum = len(imgs)
  data = np.empty((imgNum,1,12,12),dtype="float32")
  label = np.empty((imgNum,),dtype="uint8")
  for i in range (imgNum):
    img = Image.open(imgDir+imgFoldName+"/"+imgs[i])
    arr = np.asarray(img,dtype="float32")
    data[i,:,:,:] = arr
    label[i] = int(imgs[i].split('.')[0])
  return data,label
输出数据结构说明
执行上述代码后,获取的data和label均为ndarray数据类型。
data的形状为(1223, 1, 12, 12)
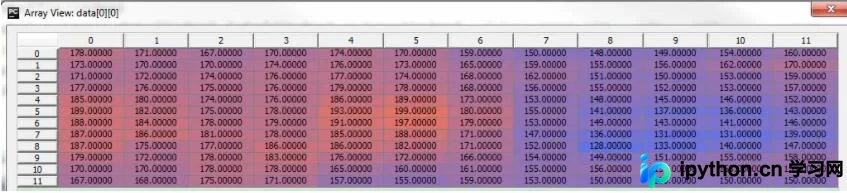
label的形状为(1223,)

注:ndarray是numpy库提供的一种数据类型,全称为N-dimensional array(N维数组)。它弥补了Python原生array模块不支持多维数组的缺陷,适合处理大规模数值计算。
调用方式
函数调用示例
craterDir = "./data/CraterImg/Adjust/"
foldName = "East_CraterAdjust12"
data, label = load_Img(craterDir,foldName)
以上即为Python读取指定文件夹下所有图像并构建数据集的完整方法,供读者参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









